Google plus. Peccato che….

Si sa che la bloggosfera,vecchio antenato del social web degli ultimi tempi, ama diffondere le novità con una tale velocità che difficilmente il blogger di turno si sofferma ad analizzare in maniera approfondita lo strumento che sta reclamando al mondo intero. In ordine cronologico, l’ultima novità nell’ecosistema della rete è la nascita del nuovo social network targato Google: Google Plus. Tralasciando la poca fantasia che gli sviluppatori e le alte cariche del colosso hanno utilizzato per rinominare il progetto, la questione Google+ è molto più profonda di quanto si possa pensare. La corsa di big G al fine di spodestare Facebook dal trono di “sito dei siti” ha spinto questa azienda ha giocarsi in qualsiasi maniera le proprie carte. Inizialmente fu la volta del defunto Wave che non ebbe il successo tanto desiderato, poi si è passati all’uccisione prematura di Buzz, altro Epic Fail nella storia dell’azienda, ed ora pare che il successo tanto inseguito sia arrivato con il neonato social network.
Ma come? Chi ha avuto modo di sperimentare Google Plus avrà notato che lo stesso permette di mantenere i contatti separati tra di loro in base ad una catalogazione di campi di interesse definite “Sfere”. Chi fa parte di una Sfera non potrà sapere cosa si dice o cosa accade in un’altra, permettendo così di mantenere un netta separazione tra gli ambiti della propria vita, che siano essi lavorativi, hobbystici, famigliari o affettivi. Un’idea brillante se si pensa che la struttura gerarchica di Facebook butta ogni contatto nello steso calderone potendo così presentarsi la situazione che la nostra ragazza e la nostra amante commentino la stessa foto dicendo “Grazie per la fantastica serata di ieri!”.
L’idea però, per quanto geniale ed altamente innovativa, non deve essere erroneamente attribuita a Google poiché l’idea esisteva già e Google Plus può essere benissimo definito una copia spudorata di un altro progetto ben più interessante: Diaspora!
Chi ha provato (e sta provando) Diaspora saprà che esso si pone l’obiettivo di creare un social network Open Source, decentralizzato e dedito al mantenimento della privacy degli utenti. Questo vorrà dire che quando il progetto arriverà a regime non si avranno i propri dati salvati in un unico luogo nella mani di una sola persona che potrà venderli ed usarli come merce di scambio ma saranno frastagliati nella rete nelle mani di nessuno. L’idea sulla quale si basa Diaspora è quella della separazione degli utenti in base a campi di interesse definiti “Aspetti”….un momento! Vi ricorda nulla? Esatto! Le Sfere di Google sono una trasposizione precisa degli Aspetti di Diaspora. Ne più, ne meno! Funzionano allo stesso modo ed hanno lo stesso scopo. Ma allora perché l’idea di Google è ritenuta geniale ed ha permesso al progetto di decollare in pochi giorni mentre Diaspora da più di anno raccatta utenti per il web?
I grandi nomi di cui amiamo riempirci la bocca in concomitanza con la mancanza d’informazione, creano una schiera di utenti dediti ad ottenere solo qualcosa che è la moda del momento. Il web si sta impoverendo di contenuti e di idee a favore di immagini demenziali e di faccine che dovrebbero rappresentare il nostro umore. È davvero questo ciò che vogliamo?
   

Progetto con Google Code – Primo commit


Dopo aver visto come ricreare in locale la cartella di lavoro presente sul server di Google Code, vediamo come creare i nostri sorgenti ed aggiornare la versione on line.

Immaginiamo di aver riempito la cartella precedentemente creata con i sorgenti del nostro programma. Al suo interno abbiamo creato una cartella di nome sorgenti che conterrà i file:
  • sorgente1.c
  • sorgente2.c
  • header.h
una cartella di nome immagini che conterrà i file
  • immagine.jpg
  • logo.png
  • banner.gif
e una file
  • readme.txt
Adesso abbiamo una struttura del tipo

cartella_progetto
|
|- sorgenti
|
|—- sorgente1.c
|—- sorgente2.c
|—- header.h
|
|- immagini
|
|—- immagine.jpg
|—- logo.png
|—- banner.gif
|
|- readme.txt

Svn, tuttavia, non sa che alla cartella del nostro progetto sono stati aggiunti dei file e pertanto dobbiamo validare le nostre aggiunte con il comando add. Add indica ad svn che il nostro progetto è stato arricchito con file che nella versione on line non sono presenti e pertanto devono essere caricati. Nel nostro caso dobbiamo spostarci nella cartella di lavoro con

$ cd cartella_progetto

e poi utilizzare la seguente sintassi

$ svn add sorgenti immagini readme.txt

Come si può notare il comando add è settato per controllare ricorsivamente e caricare l’eventuale contenuto di una cartella.

Il terminale ci risponderà con un output del tipo:

A sorgenti
A sorgenti/sorgente1.c
A sorgenti/sorgente2.c
A sorgenti/header.h
A immagini
A immagini/immagine.jpg
A immagini/logo.png
A immagini/banner.gif
A readme.txt

Se si nota bene ogni stringa è preceduta da una A che indica che il file è stato aggiunto con successo.
Ora che abbiamo indicato ad svn la nuova struttura del progetto e i nuovi file, possiamo eseguire un commit.
Il commit è l’operazione che invia i cambiamenti dei sorgenti locali sul server dove è caricato il progetto. Ogni commit eseguito equivale all’avanzamento del numero di revisione e spesso è accompagnato da una stringa che serve per descrivere brevemente il cambiamento (o i cambiamenti) più significativo. Nel nostro caso sarà:

$ svn commit -m “Primo aggiornamento sorgenti”

Dando invio ci verrà chiesta una password per abilitare le modifiche. Tale password è univoca per ogni committer del progetto (ovvero coloro che possono eseguire i commit e quindi modificare i sorgenti) e la si trova nel proprio profilo personale.
Dopo aver validato l’operazione si vedrà che il terminale ci restituisce passo passo le operazioni che sta eseguendo: caricamenti, cancellazioni, modifiche ai file del progetto, etc…

Finite tutte le operazioni otterremo una stringa del tipo

Committed revision 25

ovvero il nuovo numero di revisione. Ora i sorgenti on line sono aggiornati e i nostri utenti possono scaricare le nuove modifiche per avere il nostro software sempre perfettamente funzionante e all’ultima versione disponibile.

Alla prossima…

Progetto con Google Code – Iniziamo

Nel precedente post abbiamo visto come gettare le basi per un progetto da sviluppare grazie agli strumenti offerti da Google Code. Ora vediamo come creare nel nostro computer l’ambiente per iniziare a lavorare sui sorgenti.


Supponiamo di aver seguito alla lettera la lezione precedente. Se ciò è stato fatto, dovremmo trovarci con un link, che punta alla home del nostro progetto, del tipo:

http://code.google.com/p/NOME-VOSTRO-PROGETTO

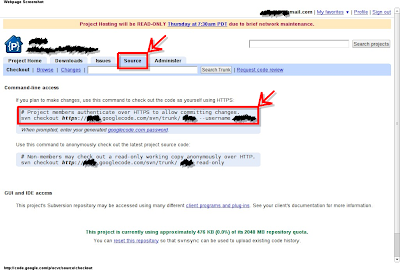
Se ci rechiamo nella pagina del progetto vedremo che tra le diverse tab ne è presente una che reca la dicitura Source. Cliccando apriremo una nuova pagina che sarà diversa a seconda dello stato del nostro account Google. Se non siamo connessi vedremo una riga di comando che permette agli utenti di scaricare il sorgente del programma senza però poterne modificare il codice, se siamo loggati, invece, avremo anche una linea di comando che permetterà a noi (e a chi partecipa al progetto) di scaricare i sorgenti e avere i privilegi per modificarli.


Questa riga è quella che interessa noi. Essa sarà del tipo:

# Project members authenticate over HTTPS to allow committing changes.

svn checkout https://NOME_PROGETTO.googlecode.com/svn/trunk/ NOME_PROGETTO --username USER_NAME


Seguite i seguenti passi:
  • Installare svn (Subversion) nel caso non sia presente nel proprio sistema;
  • Copiare la stringa che inizia con svn;
  • Aprire il proprio terminale;
  • Spostarsi nella cartella in cui si vuole creare la cartella del progetto;
  • Incollare la stringa copiata;
  • Attendere che il terminale abbia terminato di lavorare.

Fatto ciò, nella cartella in cui ci si è spostati, troveremo una cartella con il nome del nostro progetto. Essa sarà la cartella nella quale inseriremo i nostri sorgenti e nella quale lavoreremo d’ora in poi.

Nel prossimo post vedremo come caricare il primo sorgente on line.